2020年7月1日 星期三

QoS中ToS和CoS的區別?802.1p、ip pri、dscp的區別?

from:https://blog.51cto.com/imccie/1750821

談到qos首先需要了解qos調度的幾個重要過程,qos調度過程包括網絡入口數據流量的分類和標記、骨幹網設備上的擁塞避免和擁塞管理、網路出口的隊列調度這幾個重要過程.
1、cos和tos的區別:
通過acl對流量進行分類以後,緊接著就需要對報文進行標記,打標記可以在三層(ip)報文頭上做,也可以在二層報文頭上做.
tos(type of service)就是指在三層報文頭(即ip頭)作標記,cos(code of service)則是在二層報文頭作標記,tos與cos只是qos的一種標記機制。
2、802.1p、ip preference、tos、dscp的區別:
(1)、802.1p:
當需要在二層報文頭做標記的時候,由於單純二層報文沒有地方能打標記,二層打標記只能在trunk上完成,trunk要用到802.1q或isl協議,如果使用的是802.1q協議,標記會打在802.1q協議頭的tci字段上,打了標記(優先級)後的報文,就稱為802.1p報文了。
二層報文頭:
dasadatafcs

802.1q報文頭:
dasatpid
2byte
tci
2byte
ptdatafcs

tci字段結構:
tci
pri
3 bits
cfi
1 bit
vlan id
12 bits
 
tpid字段標識此報文是802.1q報文,tci字段有3bit是用來標記優先級的,如果標記了優先級就稱為802.1p報文了。
(2)、ip preference和tos:
ip報文結構如下:
versionihltype of servicepacket length
identificationflagfrag offset
time to liveprotocolheader checksum
source address
destination address
optionspadding


ip報文頭的type of sevice字段長度為1個字節,其中高3 bit用來標記優先級,所以有0-7共8個ip preference級別。
type of service字段的中間4bit為tos子字段,最低1bit未用但必須置0。4bit的tos分別代表:最小時延、最大吞吐量、最小費用和最高可靠性。4bit中只能將其中1bit置1。如果所有4bit均為0,那麼就表示是普通服務。type of service字段結構如下:
type of service
xxxdelaytroughputcostrely0
ip preferencetos長置0

(3)、dscp:
為了更精細化的控制數據流分類,rfc2474定義了dscp(differential services code point),dscp擴展了type of service字段的高6 bit來表示報文優先級,因此,標記範圍從0-63。type of service字段結構如下:
type of service
xxxxxx00
ip preference長置0

dscp定義了四個系列,default、cs系列、af系列、ef系列。
①、default :
就是默認的不做優先級,即ip preference字段都是0。
type of service
00000000
ip preference長置0

②、cs系列:
rfc2474定義最高3比特為級別/類別選擇代碼(class selector codepoints,cs),其意義和ipv4報頭中ip優先級的定義是相同的,cs0 ~ cs7的級別相當於ip優先級0 ~ 7。但它並沒有定義第3到第5比特的具體含義以及使用規則。dscp使用6比特,可以定義64個優先級(0-63)。cs系列ip報文中type of service字段結構如下:
 
type of service
00100000
ip preference長置0

.
.
.
type of service
11100000
ip preference長置0

cs = 6網間控制(internetwork control),dscp = 48 (110000).路由協議優先級默認是cs6。
cs = 7網內控制(intranetwork control),dscp = 56 (111000)
③、af :
保證轉發(assured forwarding, af)由rfc2597對cs1~cs4進行進一步定義。它使用第3和第4比特做丟棄優先級標誌。01-低丟棄優先級;10-中丟棄優先級;11-高丟棄優先級。這樣,在同一類數據中,又根據被丟棄的可能性劃分出3個級別。af11~af13,af21~af23,af31~af33,af41~af43.下表列出了af服務等級及其對應的dscp值:

cs1
00100
cs2
01000
cs3
01100
cs4
10000
low drop
01
af11
00101
af21
01001
af31
01101
af41
10001
medium drop
10
af12
00110
af22
01010
af32
01110
af42
10010
high drop
11
af13
00111
af23
01011
af33
01111
af43
10011

④、ef:
由rfc2598定義,dscp值為46 (101110)。ef服務適用於低丟包率,低延遲,低抖動及保證帶寬的業務,voip默認級別是ef。

2020年6月2日 星期二

SMI(MDC/MDIO)介紹 Clause 22/45

From:http://blog.chinaaet.com/justlxy/p/5100064818

SMI:串行管理接口(Serial Management Interface),通常直接被稱為MDIO接口(Management Data Input/Output Interface)。
MDIO最早在IEEE 802.3的第22卷定義,後來在第45卷又定義了增強版本的MDIO,其主要被應用於以太網的MAC和PHY層之間,用於MAC層器件通過讀寫寄存器來實現對PHY層器件的操作與管理。


MDIO主機(即產生MDC時鐘的設備)通常被稱為STA(Station Management Entity),而MDIO從機通常被稱為MMD(MDIO Management Device)。通常STA都是MAC層器件的一部分,而MMD則是PHY層器件的一部分。MDIO接口包括兩條線,MDIO和MDC,其中MDIO是雙向數據線,而MDC是由STA驅動的時鐘線。MDC時鐘的最高速率一般為2.5MHz,MDC也可以是非固定頻率,甚至可以是非週期的。MDIO接口只是會在MDC時鐘的上升沿進行採樣,而並不在意MDC時鐘的頻率(類似於I2C接口)。如下圖所示。
blob.png
MDIO接口有兩個版本,通常被稱為卷22版本和卷45版本。卷22版本的MDIO接口最多支持連接32個MMD(PHY層設備),每個設備最多支持32個寄存器。卷45版本的MDIO接口最多支持連接32個MMD,32個設備類型,每個設備最多支持64K個寄存器。卷22版本的MDIO接口的數據幀格式如下:
blob.png
具體每個bit描述如下:
blob.png
blob.png
卷45版本的MDIO接口的數據幀格式如下:
blob.png
具體每個bit的描述如下:
blob.png
blob.png
如果是STA(MAC層設備)驅動MDIO,則MDIO相對於MDC上升沿,至少要有10ns的建立時間(Setup Time)和10ns的保持時間(Hold Time)。如下圖所示:
blob.png
如果MDIO是由MMD(PHY層設備)驅動的,則MDIO相對於MDC的Tco(Clock to Output Delay)的範圍是0ns~300ns。如下圖所示:
blob.png
實際上,MDC的頻率也並非一定是小於或等於2.5MHz,比如Marvell的88E1512最大支持12MHz的MDC:
blob.png
IEEE 802.3建議同時對MDIO進行下拉(下拉電阻建議為2k歐姆+5%),和上拉(上拉電阻建議為1.5k歐姆+5%),使得在TA時,MDIO處於中間態。但是並非所有的PHY器件都有這樣的要求,比如Marvell的88E1512只要求對MDIO進行上拉即可,上拉電阻範圍為1.5k~10kΩ。
主要參考資料
1、IEEE 802.3 第22卷,第45卷
3、Lattice, RD1194, MDIO Master and Slave Controllers User Guide
4、Marvell,Alaska 88E1512 Datasheet

2020年2月20日 星期四

arp_ignore 和 arp_filter

From:http://huntxu.github.io/2015-12-24-arp-filter-vs-arp-ignore.html


arp_ignore 和 arp_filter

24 Dec 2015
先說結論好了
  1. arp_filter有個表哥叫做rp_filter,這裏的rpReserve Path的意思,其實就是用來檢查返回的包是否會從相對應的到來的包使用相同的網絡接口出去。它們的區別只是層次不同
  2. arp_ignore 則是內核用來確定是否應該回覆從該端口收到的ARP請求的
  3. 這兩個判斷都在內核中的net/ipv4/arp.c
故事是因爲有個同事在一個機器上用libvirt搭建了幾臺虛擬機之後使用橋接連接這幾臺機器,並且使用自動部署工具去部署這幾臺機器。結果發現其中有一臺機器的一個網卡沒有成功得到預期的地址。調查之後發現那臺機器在配置該地址之前使用了arping -D去檢查是否與其他機器已有的地址相互衝突了,剛巧該地址和宿主機之上的另外一個網卡地址相同,於是宿主機上橋接虛擬機網絡的網卡,便響應了那個ARP請求,導致配置失敗。
一開始我也很奇怪,爲什麼明明宿主機上橋接着虛擬機網絡的網卡並不擁有那個目標地址但卻會回覆,而更奇怪的是,虛擬機中使用arping不加-D參數,也收不到回覆。所以經過一番搜索與測試驗證,才大致搞明白了其中的原因。
首先,在內核文檔中有這樣一段對arp_filter參數的描述:
0 - (default) The kernel can respond to arp requests with addresses
from other interfaces. This may seem wrong but it usually makes
sense, because it increases the chance of successful communication.
IP addresses are owned by the complete host on Linux, not by
particular interfaces. Only for more complex setups like load-
balancing, does this behaviour cause problems.
內核認爲一個IP地址是屬於整個主機的,而非某個特定的端口,所以默認情況下,每個端口都會回覆目標是其他端口的IP地址的ARP請求。
查看了機器之後發現這一項爲默認值0,但是又一個疑問發生了,爲什麼使用arping不帶-D參數就無法收到返回呢?答案是rp_filter做了過濾,默認回應的包不從收到的端口出去,所以並不回覆。
那麼接下來又有一個問題,爲什麼帶了-D參數就收的到回覆呢?原因是,如果使用arping -D的話,發出的請求包的原地址是設置爲0.0.0.0的,這點可以參考RFC2131中的4.4.1一段。然後來看代碼:
    /* Special case: IPv4 duplicate address detection packet (RFC2131) */
    if (sip == 0) {
            if (arp->ar_op == htons(ARPOP_REQUEST) &&
                inet_addr_type_dev_table(net, dev, tip) == RTN_LOCAL &&
                !arp_ignore(in_dev, sip, tip))
                    arp_send_dst(ARPOP_REPLY, ETH_P_ARP, sip, dev, tip,
                                    sha, dev->dev_addr, sha, reply_dst);
            goto out;
    }
當請求包的地址爲0.0.0.0的時候,內核只照顧arp_ignore這個選項,而不去管arp_filter選項的內容,也不去管rp_filter的內容。
下面看兩個場景,加深一下對這幾個參數的印象:
  1. 主機上兩個接口,地址分別處於不同的子網之中
    • 這種情況不會引起混亂
    • 從哪個端口進來的ARP請求,一般來說請求的源地址也是那個子網之中的地址,因此回覆包也會從該端口出去,所以能通過rp_filter以及arp_filter的驗證
    • 這種情況下的回覆只需要考慮arp_ignore的影響
  2. 主機上兩個接口,地址處於相同的子網之中
    • 容易引起混亂的情況
    • 兩個端口進來的ARP請求,基本上源地址是同一個子網,因此回覆的包只會從ifindex較小(猜測,未驗證)的端口發送出去,因此從其中一個端口進來的請求有可能無法通過rp_filter以及arp_filter的驗證
    • 同樣需要考慮arp_ignore的影響,對於上面說的收到無法通過rp_filter以及arp_filter驗證的請求包的端口,除非請求的源地址爲0.0.0.0,否則便根本不會回覆,而另一端口收到的則正常,而且對兩個接口上所設置的地址,都能夠通過上述的驗證
    • 要想讓兩個端口在同一子網中互不干擾,各自使用各自的地址並各自對請求包進行回覆,則需要使用策略路由,並且將arp_filterrp_filter打開,arp_ignore正確設置
關於這些選項的具體設置值的意義,可以參考內核文檔,這裏就不複製粘貼進來加長篇幅了。總之,在能夠進行規劃的情況下,還是儘量避免容易引起混亂的情況爲好。

2019年3月25日 星期一

VXLAN vs VLAN

from:https://zhuanlan.zhihu.com/p/36165475


VXLAN(Virtual eXtensible Local Area Network)或許是目前最熱門的網絡虛擬化技術。
網絡虛擬化是指在一套物理網絡設備上虛擬出多個二層網絡。VXLAN由RFC7348定義,這是2014年定稿的一個協議,VXLAN協議將Ethernet幀封裝在UDP內,再加上8個字節的VXLAN header,用來標識不同的二層網絡。

同樣是網絡虛擬化技術的VLAN(Virtual Local Network)在1998年就提出了第一稿,並且得到廣泛的應用,VLAN直接在Ethernet幀的頭部加上4個字節的VLAN Tag,用來標識不同的二層網絡。VLAN已經在大部分的網絡設備和操作系統中得到了支持,它處理起來也比較簡單,在讀取Ethernet數據的時候,只需要根據EtherType相應的偏移4個字節就行。相比之下,VXLAN因為提出的較晚,在設備上的支持率不如VLAN,而且,VXLAN數據的封裝解封裝,要比VLAN複雜的多。看起來沒理由VXLAN搶占VLAN的地位,但是現實卻不是如此,那究竟是什麼原因導致的呢?

VXLAN協議

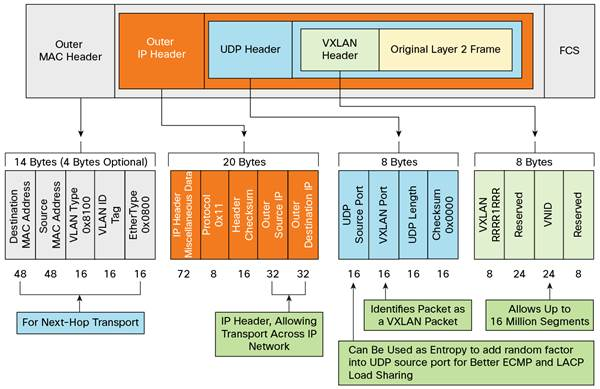
我們先來看看VXLAN協議,前面說過,VXLAN是將Ethernet Frame封裝在UDP包裡面,具體的協議格式如下。
除了常規的各層的header之外,VXLAN協議定義了8個字節的VXLAN Header。其中的24bit用來標識不同的二層網絡,這樣總共可以標識1600多萬個不同的二層網絡。一般的傳輸層端口號用來標識進程或者應用,但是在VXLAN協議裡面的,Ethernet Frame封裝在UDP裡面,UDP的source port被用來在ECMP或者LACP做負載均衡;destination port被用來標識VXLAN數據,IANA(Internet Assigned Numbers Authority)分配給VXLAN的端口號是4789。VXLAN數據是經過VTEP(VXLAN Tunnel EndPoint)封裝和解封裝的,相應的VXLAN數據的外層IP地址就是VTEP的IP地址。最外層的MAC地址用來實現VTEP之間的數據傳遞。
VXLAN與VLAN的最大區別在於,VLAN只是修改了原始的Ethernet Header,但是整個網絡數據包還是原來那個數據包,而VXLAN是將原始的Ethernet Frame隱藏在UDP數據裡面。經過VTEP封裝之後,在網絡線路上看起來只有VTEP之間的UDP數據傳遞,原始的網絡數據包被掩蓋了。
VXLAN並不是憑空出現,這種在UDP裡面封裝網絡數據的做法,在VXLAN之前就已經存在,例如OTV(Overlay Transport Virtualization)和LISP(Locator/ID Separation Protocol )。

為什麼要VXLAN?

相比VLAN,VXLAN顯得複雜很多。再加上VLAN的先發優勢,已經得到了廣泛的支持。那為什麼還要VXLAN?
VLAN ID數量限制
--
首先是VLAN能支持的二層網絡數量有限。VLAN Tag總共4個字節,其中有12bit用來標識不同的二層網絡,這樣總共是4000多個。而VXLAN header有8個字節,有24bit用來標識不同的二層網絡,這樣總共是1600多萬個。這或許是知名度最高的一條原因。但這是最根本的原因嗎?VLAN自身也有一些相關的協議,其中QinQ(IEEE 802.1 ad)定義在Ethernet頭部加上2個VLAN Tag,這樣總共也可以由12+12=24bit的數據用來標識不同的二層網絡。如果僅僅是因為能支持的二層網絡數量有限,只需要在現有的VLAN設備上做一些改動,直接用QinQ就好了。所以,選用VXLAN一定還有其他原因。
TOR交換機MAC地址表限制
--
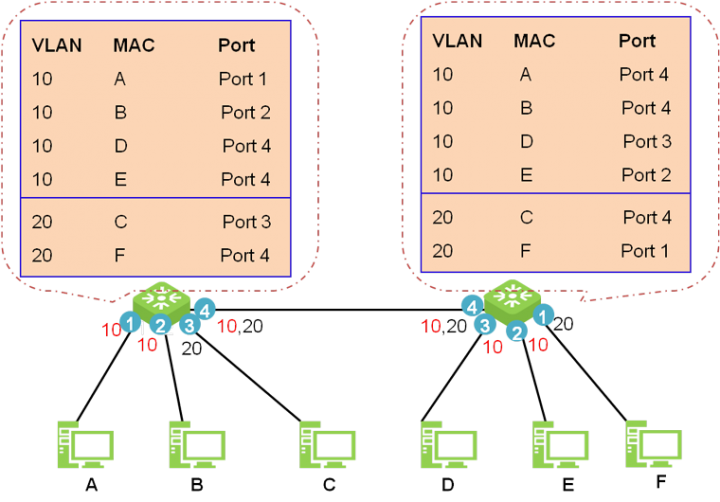
數據中心的虛擬化給網絡設備帶來的最直接影響就是:之前TOR(Top Of Rack)交換機的一個端口連接一個物理主機對應一個MAC地址,但現在交換機的一個端口雖然還是連接一個物理主機但是可能進而連接幾十個甚至上百個虛擬機和相應數量的MAC地址。傳統交換機是根據MAC地址表實現二層轉發。如下圖所示,交換機在收到一個數據幀之後,根據VLAN和目的MAC地址,查找到相應的交換機端口,再將數據幀從相應的端口發出。
這個MAC地址表是通過交換機的flood-learn學習並記錄在交換機的內存。交換機的內存比較寶貴,所以MAC地址表的大小通常是有限的。現在因為虛擬化,整個數據中心的MAC地址多了幾十倍,那相應的交換機裡面的MAC地址表也需要擴大幾十倍。如果交換機不支持這麼大的MAC地址表,那麼就會導致MAC地址表溢出。溢出之後,交換機不能將新的MAC地址學習到自己的MAC地址表。如果交換機收到這些MAC地址的數據幀,因為不能通過查表轉發,會flood到所有的端口。這不但增加了交換機的負擔,還增加了網絡中其他設備的負擔。為了避免這個問題,可以用一些更大容量的交換機,但是相應的成本也要上升,而且還不能從根本上解決這個問題。
如果使用VXLAN,虛擬機的Ethernet Frame被VTEP封裝在UDP裡面,一個VTEP可以被一個物理主機上的所有虛擬機共用。從交換機的角度,交換機看到的是VTEP之間在傳遞UDP數據。通常,一個物理主機對應一個VTEP,所以交換機的MAC地址表,只需要記錄與物理主機數量相當條目就可以了,虛擬化帶來的MAC地址表暴增的問題也不存在了。這是VXLAN能解決的,而現有的VLAN沒有辦法迴避的問題。
靈活的虛機部署和部署
--
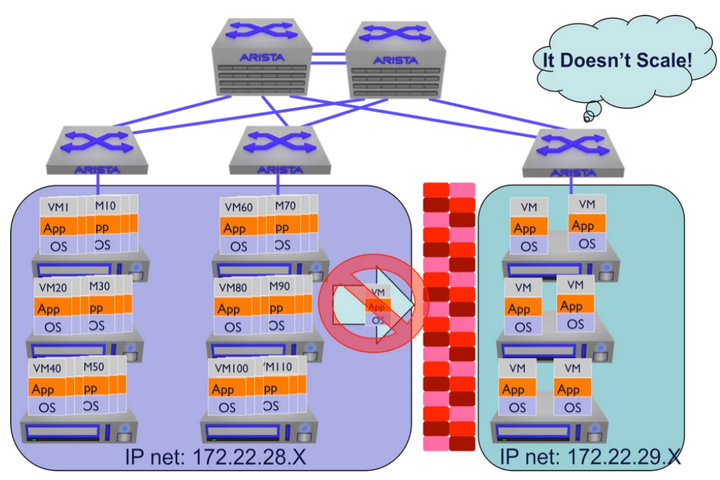
採用VLAN網絡的虛擬環境,不存在overlay網絡。虛擬機的網絡數據,被打上VLAN Tag之後,直接在物理網絡上傳輸,與物理網絡上的VLAN是融合在一起的。這樣的好處是虛擬機能直接訪問到物理網絡的設備,但是壞處是,虛擬網絡現在不能打破物理網絡的限制。比如,如果要在VLAN 100部署虛擬機,那隻能在支持VLAN 100的物理設備上部署虛機。通常不同的VLAN網絡,會被分配不同的IP地址段,通過路由器或者其他的三層設備連接在一起。設想我有下面一個環境,​​紫色區域和綠色區域分別對應不同的VLAN網絡,紫色區域裡面每個服務器已經有10個虛機,綠色區域每個服務器只有2個虛機,紫色區域雖然服務器數量更多,但是總的負擔已經夠重了。現在因為業務的需求,我們還需要向紫色網絡裡面部署虛機,因為VLAN網絡無法打破物理二層網絡的限制,虛機還是只能部署在紫色區域,這明顯不合理。
另一方面,就算不部署新的虛擬機,只是對現有的部署做一個優化,將部分虛擬機從紫色區域遷移到綠色區域,因為無法打破物理二層網絡的限制,這也是不可行的。因為業務肯定不是平均分配的,那如果採用VLAN網絡,極有可能會導致數據中心的利用率分佈不均勻。
VLAN其實有自己的解決辦法,如果將所有的交換機Trunk連接起來,那在物理上沒有明確的區域區分。但是這樣就產生了一個大的二層,相應的BUM(Broadcast,Unknown Unicast,Multicast)和交換機MAC地址表的問題也會隨之產生。
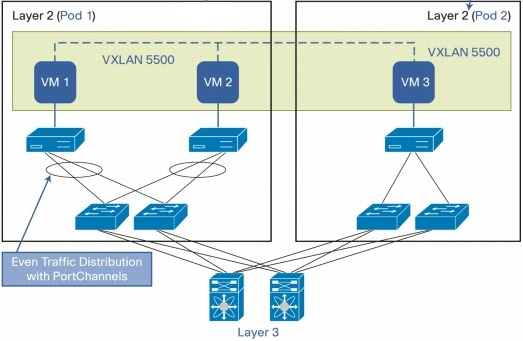
如果使用VXLAN呢?因為VXLAN通過UDP傳輸Ethernet Frame,那相應的可以在一個L3網絡上,傳遞L2的數據。又或者用官方的說法,在一個L3網絡上構建了L2網絡。物理網絡的二層邊界還存在,但是現在虛機的網絡數據在三層網絡傳輸,可以跨越物理二層網絡的限制。
不管物理網絡的二層還是三層,虛擬機現在已經感知不到了。通過VXLAN的封裝,虛擬機現在走的是一套獨立於物理網絡(underlay network)的overlay network。這樣的話,在物理網絡上,就不必把所有的交換機Trunk連起來,還是可以保持一個個小的L2 Pod。但是同時,虛擬機的部署和遷移,又不用受物理網絡的限制,整個數據中心可以保持一個平均的利用率。這是另外一個VXLAN能解決,但是VLAN無法迴避的問題。
更好的利用多條網絡鏈路
--
VLAN協議使用STP(Spanning Tree Protocol)來管理多條線路,STP根據優先級和cost,只會選出一條線路來工作,這樣可以避免數據傳遞的環路。這種主備(active-passive)的模式,比只連接一條線路肯定是有優勢,但是對於用戶來說,相當於花了N倍的錢,卻只用到了1倍的服務。當網絡流量較大的時,也不能通過增加線路來提升性能。而VXLAN因為是通過UDP封裝,在三層網絡上傳輸。雖然傳遞的還是二層的Ethernet Frame,但是VXLAN可以利用一些基於三層的協議來實現多條線路共同工作(active-active),以實現負載均衡,例如ECMP,LACP。現在對於用戶來說,花了N倍的錢,也用到了N倍的服務。當網絡流量較大時,現在可以通過增加線路來減輕現有線路的負擔。這在提升數據中心網絡性能,尤其是東西向流量的性能時,尤其重要。這是VXLAN相比VLAN,能帶來的另一個好處。

最後

所以,儘管VXLAN要復雜一些,提出的晚一些,普及率也要低一些,但是隨著數據中心規模的發展和虛擬化的普及,VXLAN逐漸成為構建數據中心網絡的趨勢。
不過理智點看,VXLAN有這麼多優點,在可以預見的未來,還是不能完全替代VLAN。首先VXLAN是一種overlay網絡,不能獨立存在,必須依賴underlay網絡,而在構建underlay網絡時,還是需要藉助VLAN。其次,這裡介紹的VXLAN的優勢,都是在大規模環境下,如果你的數據中心的規模,不論虛機還是物理的,就百十台的樣子,那直接用VLAN也可以了,沒必要上VXLAN。
VXLAN最多是在構建數據中心時的一個選項,而不是唯一的選項。套用馬斯洛的“工具法則”:當你只有一個錘子時,任何東西看起來都像是個釘子。在設計數據中心網絡時,也應該避免用一種方法解決所有問題,VXLAN,VLAN,BGP,EVPN,OpenStack應該綜合考慮。

How to repair and clone disk with ddrescue

  ddrescue  is a tool that can be used to repair and clone disks on a  Linux system . This includes hard drives, partitions, DVD discs, flas...